Google lança PLE, benchmark com 85 tarefas reais de engenharia para agentes de IA
Teste com 30 tarefas mecânicas, 27 elétricas, 18 civis e 10 estruturais mede entregáveis, e melhor IA fez 48,3% no conjunto oculto.
Em 30 segundos
- Google AI & Infrastructure liberou 29 tarefas públicas, ferramentas e contêiner do Physical-Engineering's Last Exam (PLE).
- Benchmark criado com a Mercor tem 85 tarefas de engenharia mecânica, elétrica, civil e estrutural.
- No teste oculto de 56 tarefas, nenhum modelo passou de 50%; Claude Opus 5.5 no Claude Code fez 48,3%.
- Competição aberta avalia a estrutura de agente completa em tarefas ocultas, com 3 execuções por tarefa.
O Google AI & Infrastructure anunciou, em 3 de novembro de 2026, a liberação de 29 tarefas públicas, ferramentas de avaliação e um contêiner de avaliação do Physical-Engineering's Last Exam (PLE). O PLE é um benchmark — um teste padronizado para comparar IAs — com 85 tarefas desenvolvido com a Mercor, acompanhado de uma competição aberta de agentes e um placar de classificação.
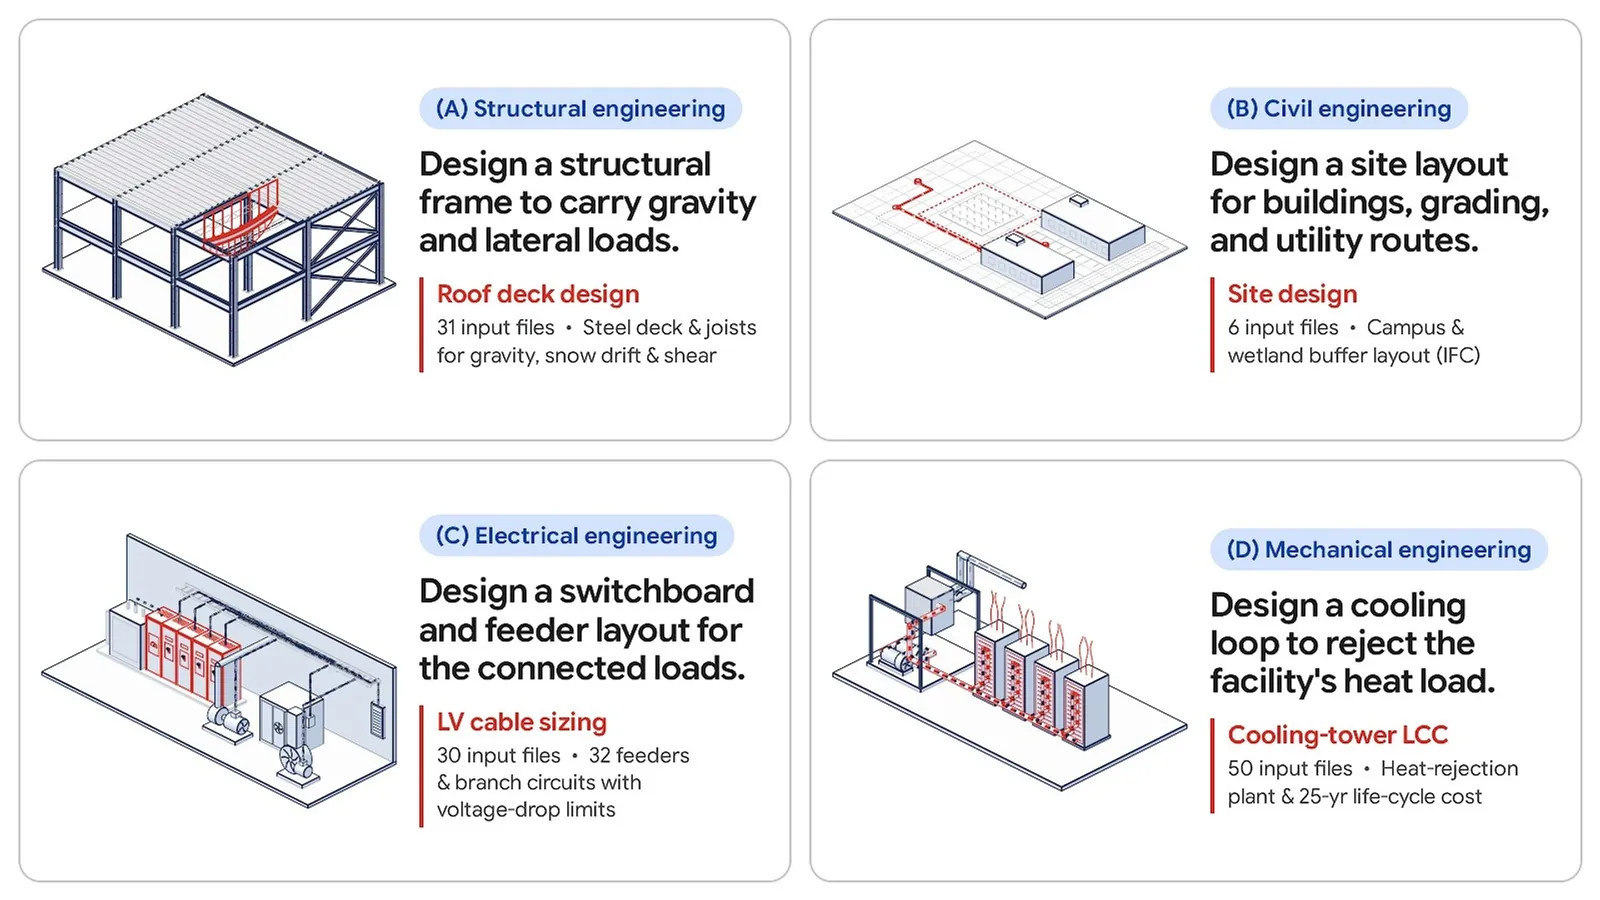
No lugar de questões de livro-texto ou de um acionamento isolado de ferramenta, o agente deve realizar atividades profissionais de engenharia mecânica, elétrica, civil e estrutural. São 30 de mecânica, 27 de elétrica, 18 de civil e 10 de estrutural. O êxito é aferido por entregas que precisam respeitar códigos de engenharia, limites físicos e, nos trabalhos de projeto, metas de custo ou desempenho.
Pastas de projeto com milhares de arquivos
Cada atividade opera em ambiente de projeto em contêiner fundamentado no Archipelago da Mercor. Há, em média, 61 arquivos por tarefa, totalizando 5.170 arquivos em todo o benchmark, entre PDFs, planilhas, e-mails, desenhos CAD em 2D, modelos BIM em 3D e revisões trocadas por edições mais novas. Cabe ao agente identificar quais documentos são válidos, executar cálculos e produzir arquivos como memorandos, planilhas de cálculo, listas de equipamentos e desenhos para exame por profissionais licenciados.
Do total de 85 tarefas, 44 tiveram elaboração de especialistas, com pastas de projeto, enunciados e rubricas ponderadas de avaliação criados totalmente por engenheiros em atividade. As 41 restantes tiveram elaboração em coautoria: engenheiros forneceram os briefings iniciais e um processo adversarial Creator-Solver montou e testou ambientes e avaliadores executáveis a partir de materiais reais. Em seguida, especialistas validaram as tarefas e elevaram a dificuldade. O artigo técnico declara que nenhuma tarefa contém informações proprietárias ou confidenciais de clientes.
Como a nota é calculada
As tarefas de especialistas adotam pontuação ponderada, atrelada a provas encontradas nos arquivos enviados. As tarefas de projeto em coautoria combinam o cumprimento de restrições com uma meta econômica ou de performance: caso um limite inflexível de segurança ou de viabilidade não seja superado, o projeto não soma pontos pelo objetivo. Isso resolve um gargalo da avaliação apenas por rubrica, em que duas listas de cabos podem passar nas mesmas verificações e ter custos diferentes de instalação.
O Google testou 14 modelos com sete estruturas de agentes de acesso público, rodando cada tarefa três vezes por configuração. Os contêineres de execução funcionavam sem acesso à internet e com limite de seis horas por rodada. A avaliação por rubrica e a correção executável permaneciam fora do contêiner, deixando avaliadores e entregáveis de referência fora do alcance do agente.
Ninguém passou de 50% no teste oculto
No conjunto reservado de avaliação com 56 tarefas, nenhum modelo passou dos 50% de pontuação em seu arcabouço original de agente. O maior resultado foi obtido pelo Claude Opus 5.5 rodando no Claude Code, com 48,3%, sendo esse recorte sigiloso o que alimenta o ranking da disputa. Em outra medição, considerando as 85 tarefas, o mesmo arranjo marcou 50,6%, com média de 27 milhões de tokens — o bloco elementar de texto que a IA interpreta — e 63 minutos por tarefa, ao custo de US$ 17,18 por tarefa pelos valores de tabela.
O dado mais revelador está nas tarefas em coautoria: a melhor configuração cumpriu 91% das restrições individuais, mas apenas 41,3% dos itens passaram por todas as verificações rígidas de segurança e viabilidade para receber crédito pelo objetivo. Ou seja, os agentes acertam a maioria dos requisitos isolados, mas falham em entregar um projeto totalmente conforme. O Google também relata diferença de aproximadamente 50 pontos entre modelos, contra diferença mediana de três pontos entre estruturas para o mesmo modelo, além de variação média de 15,4 pontos entre as três execuções de cada tarefa.
Na disputa, o repositório separa o PLE em 29 tarefas públicas de desenvolvimento e 56 ocultas de teste. O participante submete a estrutura de agente — o software que orienta o modelo durante a tarefa — com a escolha do modelo e os artefatos das tarefas públicas. Os organizadores analisam esses artefatos, repetem uma amostra para verificar a reprodutibilidade e realizam três rodadas nas ocultas para definir a pontuação. Dá para utilizar sem custo 13 modelos patrocinados pelo Google no servidor de avaliação, informar uma chave comercial de API ou conectar um servidor auto-hospedado. O repositório, sob licença Apache-2.0, oferece exemplos e adaptadores para agentes já existentes.
Fontes
Os fatos desta notícia vêm destes veículos:
- Unite.AI “Google lança benchmark de engenharia com 85 tarefas e competição de agentes”
Texto produzido com apoio de inteligência artificial a partir das fontes citadas e revisado antes de publicar. A apresentação em vídeo é gerada por IA.
Adicionar o CodeMago News às fontes preferidas no Google