Google lanza PLE, benchmark con 85 tareas reales de ingeniería para agentes de IA
Prueba con 30 tareas mecánicas, 27 eléctricas, 18 civiles y 10 estructurales mide entregables, y la mejor IA logró 48,3% en el conjunto oculto.
En 30 segundos
- Google AI & Infrastructure liberó 29 tareas públicas, herramientas y contenedor de evaluación de Physical-Engineering's Last Exam (PLE).
- Benchmark creado con Mercor tiene 85 tareas de ingeniería mecánica, eléctrica, civil y estructural.
- En la prueba oculta de 56 tareas, ningún modelo superó el 50%; Claude Opus 5.5 en Claude Code logró 48,3%.
- Competencia abierta evalúa el sistema completo de agente en tareas ocultas, con 3 ejecuciones por tarea.
Google AI & Infrastructure anunció, el 3 de noviembre de 2026, la liberación de 29 tareas públicas, herramientas de evaluación y un contenedor de evaluación de Physical-Engineering's Last Exam (PLE). PLE es un benchmark — una prueba estandarizada para comparar IAs — con 85 tareas desarrollado con Mercor, acompañado de una competencia abierta de agentes y una tabla de clasificación.
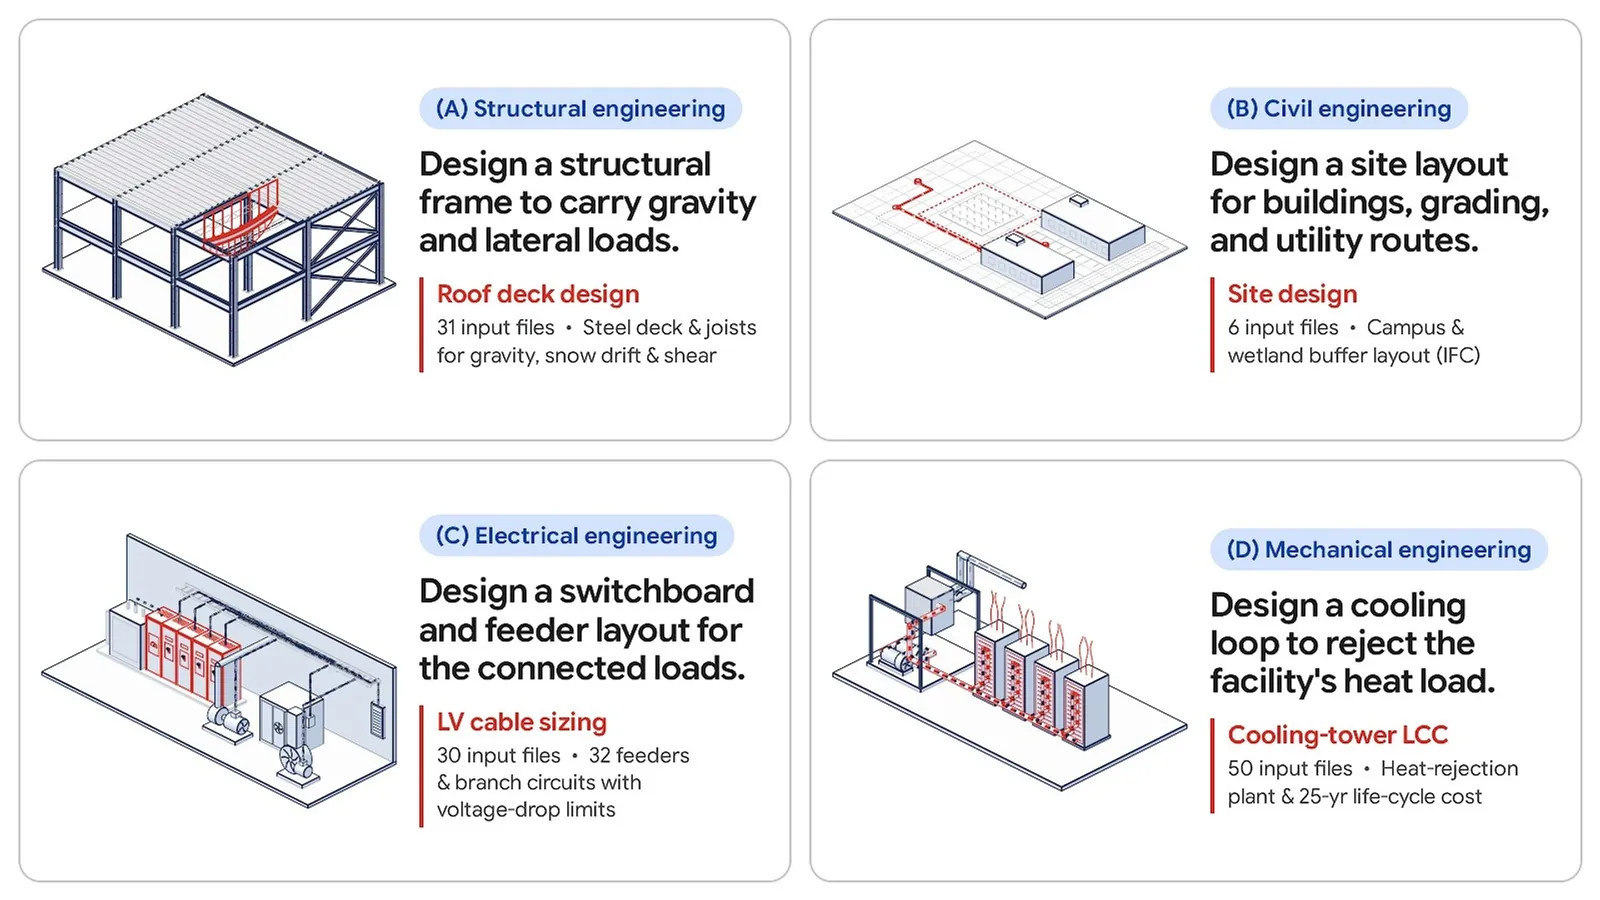
En lugar de preguntas de libro de texto o una sola llamada aislada a una herramienta, el agente debe realizar actividades profesionales de ingeniería mecánica, eléctrica, civil y estructural. Son 30 de mecánica, 27 de eléctrica, 18 de civil y 10 de estructural. El éxito se mide por entregables que deben respetar códigos de ingeniería, límites físicos y, en los trabajos de diseño, metas de costo o desempeño.
Carpetas de proyecto con miles de archivos
Cada actividad opera en un entorno de proyecto en contenedor basado en Archipelago de Mercor. Hay, en promedio, 61 archivos por tarea, con un total de 5.170 archivos en todo el benchmark, entre PDF, hojas de cálculo, correos electrónicos, dibujos CAD en 2D, modelos BIM en 3D y revisiones reemplazadas por ediciones más nuevas. El agente debe identificar cuáles documentos son válidos, ejecutar cálculos y producir archivos como memorandos, hojas de cálculo, listas de equipos y dibujos para revisión por profesionales licenciados.
Del total de 85 tareas, 44 fueron elaboradas por especialistas, con carpetas de proyecto, enunciados y rúbricas ponderadas de evaluación creados totalmente por ingenieros en actividad. Las 41 restantes fueron elaboradas en coautoría: ingenieros aportaron los briefings iniciales y un proceso adversarial Creator-Solver construyó y probó entornos y evaluadores ejecutables a partir de materiales reales. Luego, especialistas validaron las tareas y elevaron la dificultad. El artículo técnico declara que ninguna tarea contiene información propietaria o confidencial de clientes.
Cómo se calcula la calificación
Las tareas de especialistas usan puntuación ponderada, vinculada a evidencia encontrada en los archivos enviados. Las tareas de diseño en coautoría combinan el cumplimiento de restricciones con una meta económica o de rendimiento: si no se supera un límite inflexible de seguridad o viabilidad, el proyecto no suma puntos por el objetivo. Esto resuelve un cuello de botella de la evaluación solo por rúbrica, en la que dos listas de cables pueden pasar las mismas verificaciones y tener costos de instalación diferentes.
Google probó 14 modelos con siete estructuras de agentes de acceso público, ejecutando cada tarea tres veces por configuración. Los contenedores de ejecución funcionaban sin acceso a internet y con un límite de seis horas por ronda. La evaluación por rúbrica y la corrección ejecutable permanecían fuera del contenedor, dejando evaluadores y entregables de referencia fuera del alcance del agente.
Nadie superó el 50% en la prueba oculta
En el conjunto reservado de evaluación con 56 tareas, ningún modelo superó el 50% de puntuación en su estructura de agente original. El mejor resultado fue el de Claude Opus 5.5 ejecutado en Claude Code, con 48,3%, siendo este recorte confidencial el que alimenta el ranking de la competencia. En otra medición, considerando las 85 tareas, el mismo arreglo marcó 50,6%, con un promedio de 27 millones de tokens — el bloque elemental de texto que la IA interpreta — y 63 minutos por tarea, a un costo de US$17,18 por tarea a precios de lista.
El dato más revelador está en las tareas en coautoría: la mejor configuración cumplió 91% de las restricciones individuales, pero solo 41,3% de los ítems pasó todas las verificaciones estrictas de seguridad y viabilidad para recibir crédito por el objetivo. Es decir, los agentes aciertan la mayoría de los requisitos aislados, pero fallan en entregar un proyecto totalmente conforme. Google también reporta una diferencia de aproximadamente 50 puntos entre modelos, frente a una diferencia mediana de tres puntos entre estructuras para el mismo modelo, además de una variación promedio de 15,4 puntos entre las tres ejecuciones de cada tarea.
En la competencia, el repositorio divide PLE en 29 tareas públicas de desarrollo y 56 ocultas de prueba. El participante envía la estructura de agente — el software que orienta al modelo durante la tarea — con la elección del modelo y los artefactos de las tareas públicas. Los organizadores analizan esos artefactos, repiten una muestra para verificar la reproducibilidad y realizan tres rondas en las ocultas para definir la puntuación. Se pueden utilizar sin costo 13 modelos patrocinados por Google en el servidor de evaluación, informar una clave comercial de API o conectar un servidor autoalojado. El repositorio, bajo licencia Apache-2.0, ofrece ejemplos y adaptadores para agentes ya existentes.
Fuentes
Los hechos de esta noticia vienen de estos medios:
- Unite.AI “Google lança benchmark de engenharia com 85 tarefas e competição de agentes”
Texto producido con apoyo de inteligencia artificial a partir de las fuentes citadas y revisado antes de publicar. La presentación en video es generada por IA.
Añadir CodeMago News a las fuentes preferidas en Google