
Benchmarks
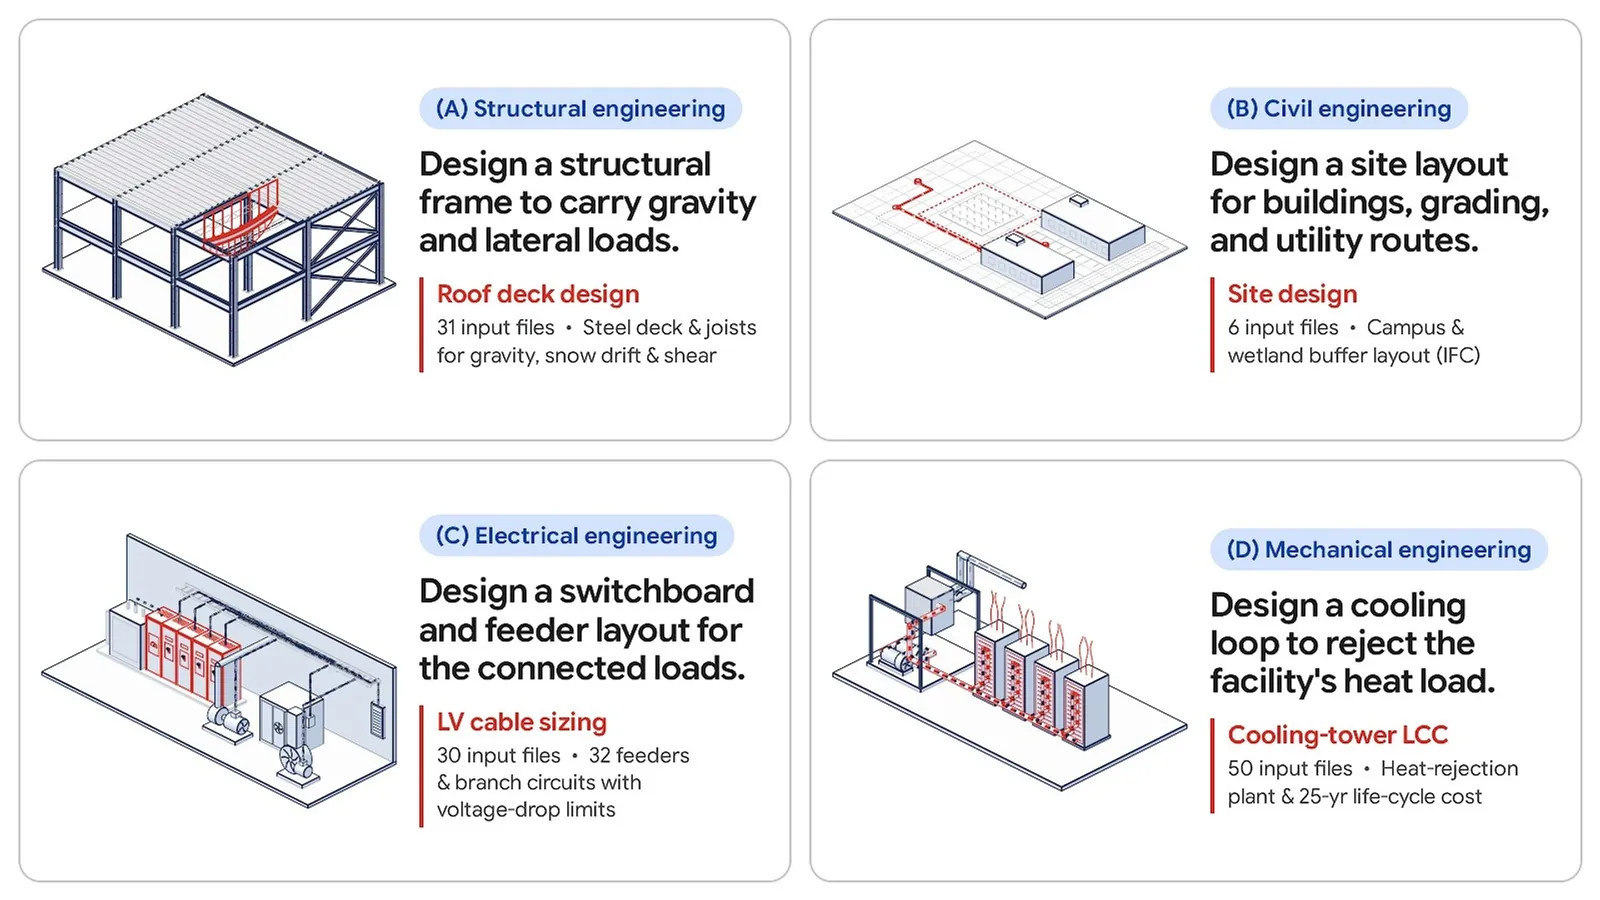
Google lanza PLE, benchmark con 85 tareas reales de ingeniería para agentes de IA
Prueba con 30 tareas mecánicas, 27 eléctricas, 18 civiles y 10 estructurales mide entregables, y la mejor IA logró 48,3% en el conjunto oculto.
Rankings y pruebas de IA: LMArena, SWE-bench, ARC-AGI, GPQA y Artificial Analysis. Quién subió, quién bajó y por cuánto.
Prueba con 30 tareas mecánicas, 27 eléctricas, 18 civiles y 10 estructurales mide entregables, y la mejor IA logró 48,3% en el conjunto oculto.
Anunciado el 2 de noviembre de 2026, el benchmark evalúa cuidados, hogar y servicios públicos por el resultado final.
SemiAnalysis lanzó GDPx con 206 tareas reales; Claude Opus 5.5 lidera con 12.0%, por delante de Gemini 4 Carbon y GPT-6 Astra.
La nueva metodología usa 60% de pruebas privadas y deja a Astra con 57 y a Sol con 55 puntos detrás del líder, según Artificial Analysis.