OpenAI crea la prueba LifeVal para medir la IA en tareas de la vida real
Anunciado el 2 de noviembre de 2026, el benchmark evalúa cuidados, hogar y servicios públicos por el resultado final.
En 30 segundos
- OpenAI anunció el 2 de noviembre de 2026 LifeVal, una evaluación de tareas cotidianas.
- La prueba cubre cuidados, administración del hogar y servicios del gobierno, sin nueva función para el consumidor.
- La selección usa investigación sobre uso del tiempo y una encuesta a 3,995 personas.
- El enfoque es pasar de la buena respuesta al resultado confiable, con el plazo y el documento correctos.
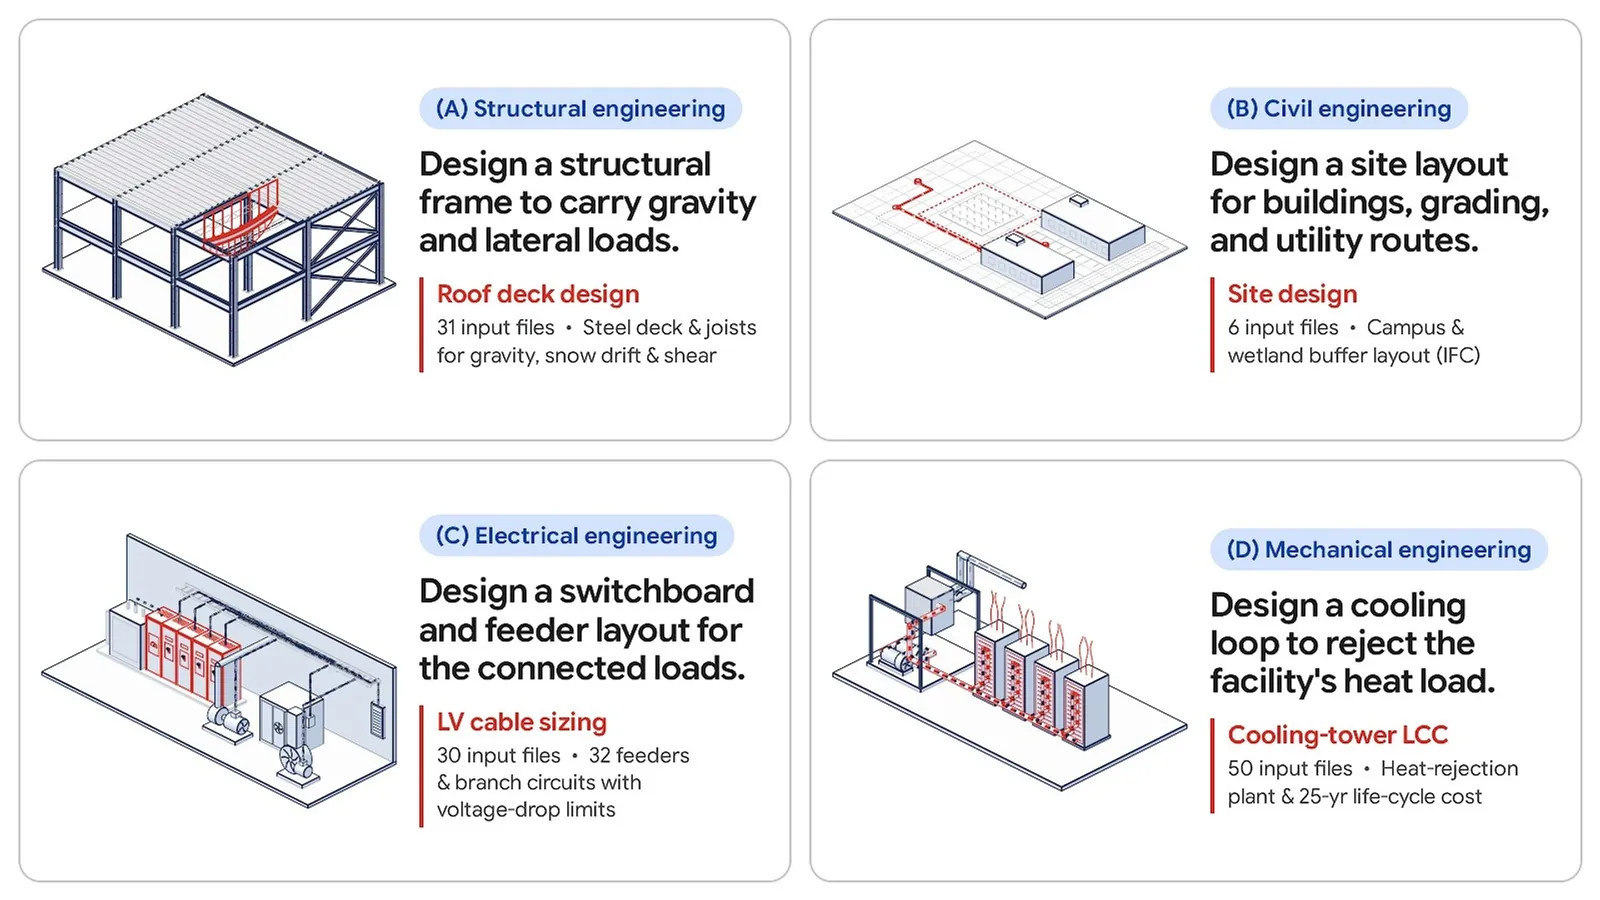
OpenAI anunció el 2 de noviembre de 2026 LifeVal, una evaluación para medir a los asistentes de IA en tareas del día a día. Las pruebas cubren cuidado de personas, administración del hogar y servicios del gobierno. No se trata de una nueva función para el consumidor.
La propuesta es directa: probar la IA en el trabajo que las personas realmente quieren delegar. El artículo dice que OpenAI usó LifeVal internamente durante el último año. La selección de tareas se apoya en investigación sobre uso del tiempo y en una encuesta descrita como demográficamente representativa con 3,995 entrevistados.
De la respuesta útil al resultado confiable
El ejemplo central es inscribir a un niño en la escuela. Parece simple, pero exige verificar el distrito correcto, encontrar el plazo, identificar documentos, validar la dirección y decidir si el formulario debe enviarse ahora o revisarse antes. Una buena respuesta ayuda, pero solo un proceso completo resuelve la vida de la familia.
Ahí es donde la evaluación se vuelve más difícil. Las pruebas tradicionales de IA suelen tener un formato cerrado, como una pregunta con respuesta, un reto de código con pruebas o un resumen de documento. La rutina administrativa es desordenada: empieza con una búsqueda, pasa por un formulario, se pausa para una decisión familiar y solo termina días después, cuando alguien confirma que fue aceptado.
Tiempo, contexto y límites
Para elegir qué evaluar, LifeVal recurre a fuentes como la American Time Use Survey, que mide cómo las personas en Estados Unidos usan su tiempo, y el Multinational Time Use Study, que armoniza diarios de varios países. Como este segundo estudio incluye datos del primero, los totales no deben tratarse como grupos totalmente separados.
Estas fuentes muestran la forma de la vida diaria, pero por sí solas no dicen qué quieren delegar las personas a la IA, si la tarea puede delegarse con seguridad o si la ayuda realmente mejora la vida. Una hora cocinando puede ser placer para uno, necesidad de adaptar receta y costo para otro, y plan impreso por falta de internet para un tercero. El tiempo ahorrado no mide la urgencia: revisar un plazo de cinco minutos puede valer más que una hora de ocio.
Lo que aún falta saber sobre la calificación
La página de OpenAI deja abierto el denominador de la puntuación, el número de intentos y el criterio de mejor resultado seleccionado. Un pico alcanzable no muestra el desempeño típico, la variación entre intentos, cuántas veces tuvo que intervenir la persona ni los tipos de errores que quedan. Sin denominador y regla de puntuación, el lector no interpreta el porcentaje con precisión.
El artículo sostiene que un buen informe mostraría por separado la tasa de conclusiones correctas, el progreso parcial y los errores con consecuencias. Nueve pasos correctos seguidos de un pago al destinatario equivocado no es un casi acierto. También importa todo el escenario: modelo, instrucciones, herramientas, cuentas, entorno, tiempo permitido y ayuda humana, además de permisos, privacidad, límite de gasto y cuándo detenerse y pedir aprobación es lo correcto.
Fuentes
Los hechos de esta noticia vienen de estos medios:
- Kingy AI “OpenAI LifeVal Explained: Everyday AI Benchmark”
Texto producido con apoyo de inteligencia artificial a partir de las fuentes citadas y revisado antes de publicar. La presentación en video es generada por IA.
Añadir CodeMago News a las fuentes preferidas en Google